H Company rilis NeoMME, encoder multimodal 260M dan 800M tanpa vision tower. Performa setara model 14× lebih besar.
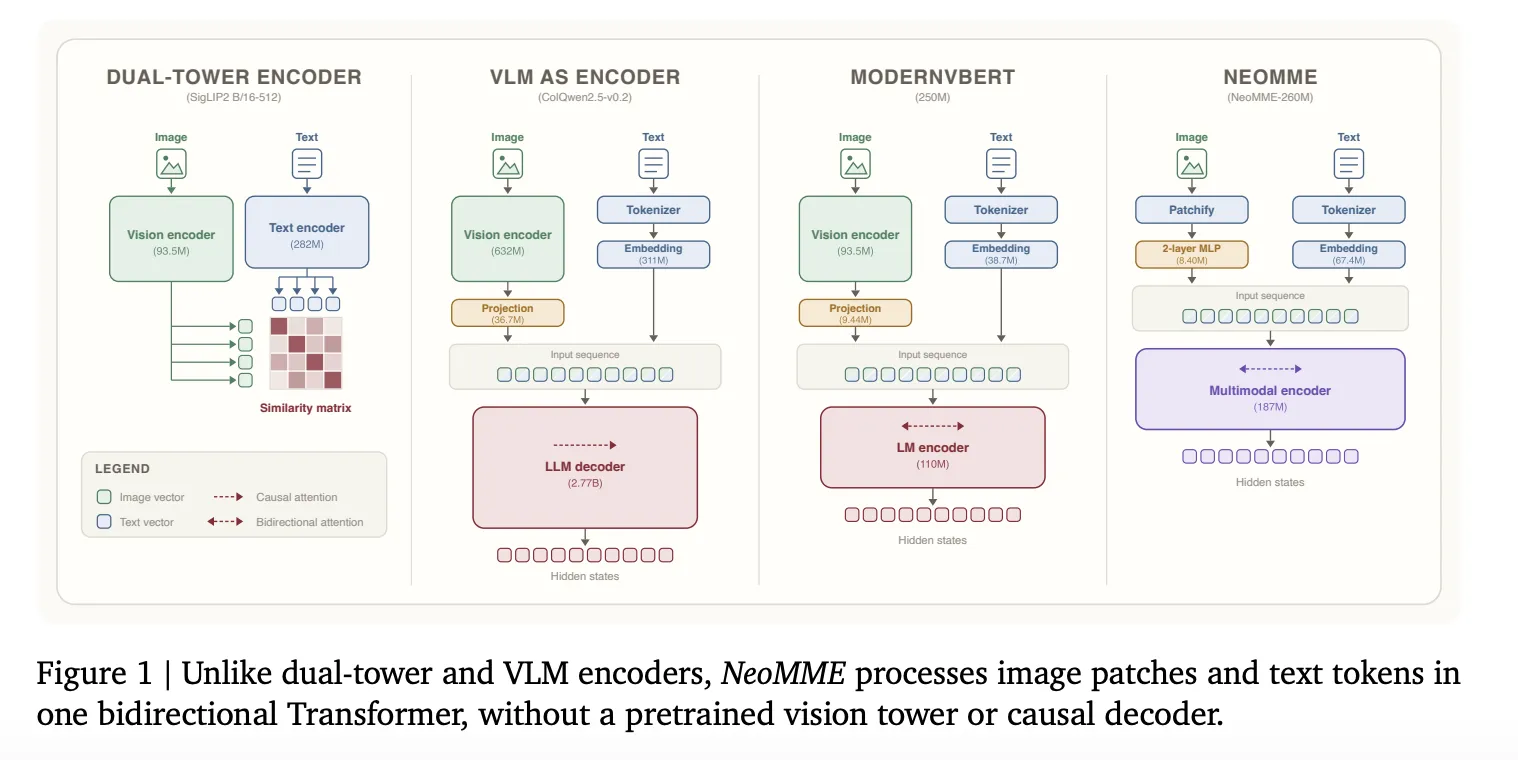
Kalau kamu sering ngulik model AI buat dokumen visual, pasti udah akrab sama pendekatan ColPali dan keturunannya. Masalahnya, model-model itu ngambil vision-language model generatif terus dipake sebagai encoder, jadi masih nyertain vision tower yang udah dilatih terpisah dan causal decoder yang sebenernya nggak pernah bikin token. Buat tugas retrieval yang cuma butuh representasi, itu beban parameter dan komputasi yang percuma. Nah, H Company ngeluarin NeoMME buat ngatasin masalah itu dengan cara radikal: buang dua komponen itu sekaligus.
NeoMME datang dalam dua ukuran, 260M dan 800M parameter, dan keduanya dilatih dari awal alias random initialization. Teks masuk lewat embedding terfaktorisasi gaya ALBERT, dimensi lookup 256 yang di-proyeksikan ke lebar model. Gambar dipotong jadi patch 32×32 tanpa tumpang tindih, terus di-proyeksikan pakai MLP 2 lapis yang juga dilatih dari nol. Nggak ada patch-merging module, nggak ada menara SigLIP2, semuanya lewat satu tumpukan Transformer yang sama. Konteksnya support sampai 16.384 token, cukup buat nampung dua gambar 4K UHD ukuran 3.840×2.160 setelah patching.
Dilatih sebagai denoiser diffusion diskret bertopeng
Pretraining-nya pakai pendekatan masked diffusion diskret di atas teks, dan opsional dikondisikan sama patch gambar yang masih kelihatan. Buat segmen teks murni, tingkat korupsinya disampling seragam dari 0 sampai 1, jadi model bener-bener belajar nebak token yang hilang dari konteks sekitarnya. Buat segmen multimodal, rentangnya dipangkas dari 0.30 sampai 1, supaya model nggak nyontek lewat bahasa doang dan dipaksa beneran baca visual di halaman. Probe ablasi cross-modal ngekonfirmasi trik ini jalan.
Advertisement
Slot in-article yang tampil setelah paragraf ketiga.
Pada tingkat masking 90%, patch halaman yang kelihatan ningkatin akurasi masked-token sampai 38.4 poin buat model 260M dan 40.5 poin buat model 800M. Tiap run ngelola sekitar 524 miliar packed input token, di mana kira-kira 290 miliar di antaranya teks murni, jalan di 16 dan 32 akselerator H100. Arsitektur attention-nya pakai grouped-query attention, query-key normalization, gated attention, 2D rotary position embeddings, dan squared-ReLU MLP. Kebanyakan layer pakai symmetric sliding-window attention, sementara tiap layer keenam dan layer final attend secara global biar tetep nangkep konteks panjang.
Hasil retrieval: kecil tapi ngalahin model gede
NeoMME-Retriever nambahin dua head yang dilatih bareng di atas backbone yang sama: dense head mean-pooled dengan lebar Matryoshka, plus late-interaction head yang proyeksin tiap token dan patch ke 128 dimensi. Satu forward pass langsung ngasih dua skor sekaligus, jadi inference-nya irit. Di benchmark ViDoRe v3, model 260M dapet 0.523 nDCG@10, dan model 800M nyentuh 0.556. Angka 260M itu jaraknya cuma 0.002 dari ColQwen2.5-v0.2 yang punya 3.75B parameter, dan 26.1 poin di atas model sub-300M terbaik lainnya. Sementara itu model 800M cuma ketinggalan 0.9 poin dari Vultron Retriever Flash yang ukurannya mirip.
Di ViDoRe v1 dan v2, angkanya juga kuat: 0.860/0.522 dan 0.874/0.559 dalam metrik nDCG@5. Tapi soal retrieval teks murni, NeoMME masih kalah. Di BEIR-15, late interaction-nya cuma nyampe 0.4881 dan 0.5126, jauh di bawah LateOn 149M yang dapet 0.5722. Penulisnya nyebut salah satu biang keroknya skala supervisi: NeoMME cuma ngliat sekitar 430 ribu contoh query teks, padahal mLateOn ngliat sekitar 660 juta contoh kontrastif. Jadi kalau use case kamu retrieval teks murni, model ini belum jadi pilihan pertama.
Penyimpanan kecil, throughput kencang, dan siap deploy
Indeks late-interaction itu emang terkenal mahal di storage. Halaman 2.048×2.048 nghasilin 4.162 vektor, kira-kira 1.5 MB per dokumen ViDoRe v3 dalam format float32. Dua jurus dikasih buat nurunin itu. Pertama, hierarchical token pooling di faktor 10 plus kuantisasi int8 buat query dan dokumen, hasilnya 39.0 kB per halaman atau kompresi 39.4× dengan nDCG@10 yang dipertahankan 99.16%. Kedua, pool faktor 8 dengan int8 query dan binary documents, hasilnya cuma 6.0 kB atau kompresi 255.5× dengan 95.19% kualitas baseline. Buat konteks, itu ngurangin storage per halaman dari segede foto Instagram jadi sekecil potongan teks.
Soal kecepatan, NeoMME-260M ngindexin 51.3 halaman per detik di satu NVIDIA L40S, hampir 2× lipat lebih cepet dari ColModernVBERT yang cuma 26.0. Encode query-nya juga ringan, 78.3 ms di host CPU-only doang. Semua checkpoint keluar di bawah lisensi Apache 2.0 dan udah support dari hari pertama di Hugging Face Transformers, jadi tinggal pull dan langsung pake. Buat kamu yang lagi bangun pipeline RAG atau document search, kombinasi lisensi terbuka, performa setara model raksasa, dan kompresi storage yang brutal ini lumayan ngeganti cara mikirin arsitektur retrieval.
- Pelajaran praktis: kalau use case kamu retrieval dokumen visual, NeoMME-260M kasih performa setara ColQwen2.5 3.75B dengan storage 255× lebih kecil, dan siap deploy pakai lisensi Apache 2.0 dari Hugging Face hari ini juga.
- Pelajaran praktis: buat retrieval teks murni, model ini belum ngalahin LateOn, jadi sebaiknya tetep pake model retrieval teks khusus kecuali kamu emang butuh kemampuan multimodal di dokumen yang sama.
Catatan redaksi
Kalau lo cuma ambil satu hal dari artikel ini
AI Updates update dari MarkTechPost.
Sumber asli
Artikel ini merupakan rewrite editorial dari laporan MarkTechPost.
Baca artikel asli di MarkTechPost→